5. Complément du module : priorités, Linux O(1) et CFS
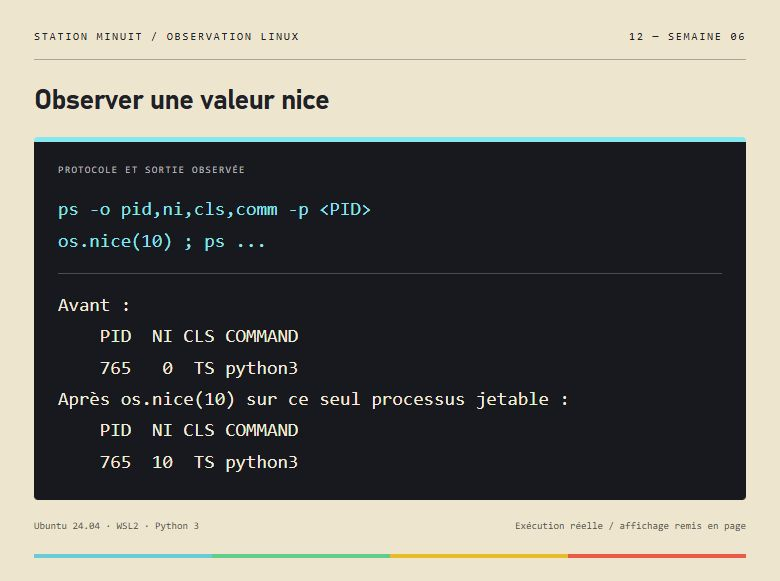
Un processus jetable passe de NI = 0 à NI = 10. Seule sa propre valeur est modifiée; aucune priorité d’une autre application ne change.
- Une valeur nice plus élevée réduit la faveur relative sous les politiques concernées.
- Ce relevé ne mesure ni un partage CPU garanti, ni un temps de réponse, ni une politique FCFS ou Round Robin.
Lire la capture en texte
ps -o pid,ni,cls,comm -p <PID>
os.nice(10) ; ps ...

Avant :
    PID  NI CLS COMMAND
    765   0  TS python3
Après os.nice(10) sur ce seul processus jetable :
    PID  NI CLS COMMAND
    765  10  TS python3
Démonstration Station Minuit · Ubuntu 24.04 / WSL2 · Python 3 · 15 octobre 2026 (Toronto). Sortie réelle remise en page et capturée; exemple ajouté, distinct du matériel officiel.
5.1. Priorité et sélection à deux niveaux
Les applications n’ont pas les mêmes besoins : défragmentation, jeu en ligne, vérification du courrier et traitement de texte ne demandent pas la même réaction. Une priorité peut favoriser une réponse rapide ou une plus grande part de CPU; ces effets sont distincts.
Une organisation simple utilise une file par niveau : choisir d’abord le niveau admissible le plus prioritaire, puis la tâche dans ce niveau, par exemple avec RR. Un tourniquet entre pairs n’impose pas d’alterner toutes les tâches, quelles que soient leurs priorités.
Lire la convention de numérotation : le schéma générique du PDF place 4 au-dessus de 1; les schémas Linux utilisent ensuite petit numéro interne = grande priorité. Reprendre le signe d’un modèle différent inverserait les choix.
5.2. O(1) : active, expirée et epoch
Le support étudie explicitement Linux 2.6.8.1. C’est un modèle historique, avec 140 niveaux et une paire de structures par CPU : active et expirée, chacune organisée par priorité. Les niveaux NORMAL vont 100 à 139; les niveaux internes plus prioritaires servent au temps réel.
L’active contient les tâches dont la tranche du passage doit encore être servie. Une tâche qui la consomme et reste exécutable passe à l’expirée. Quand l’active est vide, le système échange les pointeurs : l’expirée devient active et un nouvel epoch commence. Les niveaux sont en nombre fixe et l’échange n’exige pas de parcourir toutes les tâches pour reconstruire leur ordre à chaque choix.
Le nom O(1) qualifie le coût de sélection du modèle, pas le temps nécessaire pour exécuter N tâches pendant un cycle. Ces tâches doivent toujours consommer leur CPU. La chronologie du PDF situe O(1) entre les anciennes files multiniveaux et CFS; l’intégration de CFS est dans Linux 2.6.23. La documentation actuelle évoque ensuite EEVDF à partir de 6.6 : ce repère date le modèle et n’ajoute pas EEVDF comme mécanisme à apprendre dans ce support. Documentation CFS, documentation EEVDF.
5.3. FIFO, RR et NORMAL dans le modèle par priorités
| Politique | Entre tâches de même priorité | Préemption à distinguer |
|---|---|---|
SCHED_FIFO |
Ordre d’arrivée, sans quantum | Une tâche plus prioritaire peut préempter |
SCHED_RR |
Tourniquet avec quantum par niveau | Expiration du quantum ou arrivée plus prioritaire |
SCHED_NORMAL |
Priorités et tranches ordinaires du modèle | Préemption et transfert active→expirée |
Le « pas de préemption » écrit sur la diapositive FIFO signifie ici pas de rotation forcée par quantum entre pairs. Ce n’est pas l’absence absolue de préemption : les schémas suivants montrent l’exception de priorité supérieure.
Le premier schéma place P1 au niveau 0, P2 à 1, P3/P4 à 2 et P5 à 3. Sans nouvelle arrivée, servir P1, P2, P3, P4, P5, P3 avant P4 parce qu’il est en tête de leur niveau. Une autre animation fait finir P1 puis commencer P3; P2 devient prêt au niveau 1 et préempte P3 au niveau 2. Quand P2 ne reste plus prêt, reprendre les candidats prioritaires restants, dont P3 avant P4, puis P5. Aucun temps numérique n’est fourni pour ces dessins; il ne faut pas leur inventer des durées.
Le schéma RR place P1/P2 au niveau 0, P3/P4 à 2, P5 à 3. La trace est P1, P2, P1, P3, P4, P3, P3, P3, P5 : d’abord partager le niveau 0, puis le niveau 2 une fois 0 épuisé. P3 peut obtenir plusieurs tranches consécutives lorsqu’il est seul à son niveau. La règle n’est donc pas « chaque tâche du système à tour de rôle ».
Les tâches temps réel prêtes FIFO/RR passent avant NORMAL dans ce modèle. La phrase « lorsqu’elles ont toutes terminé » doit être lue avec cette condition de disponibilité : une tâche temps réel bloquée n’occupe pas le CPU en attendant. Une charge temps réel toujours prête peut empêcher la progression des tâches ordinaires. Les limites de configuration d’un Linux actuel ne sont pas développées par le PDF.
5.4. NORMAL : nice, correction dynamique et signe
La composante statique est représentée par nice∈[−20,+19], zéro par défaut, avec nice et setpriority() comme interfaces citées. Nice négatif augmente la priorité; positif la diminue. Le système ajoute une correction dynamique heuristique selon le comportement, notamment les périodes bloquées : favoriser les courtes rafales suivies d’E/S améliore la reprise de ces tâches.
La formule pédagogique est :
Source TeX à sélectionner et copier
P_{sched}=120+P_{statique}+P_{dynamique},\qquad
P_{statique}\in[-20,19],\quad P_{dynamique}\in[-5,5].
Le résultat reste dans [100,139]. Des sommes brutes 95 ou 144 ne sont pas des niveaux NORMAL valides. Avec nice 0, correction−5→115, plus prioritaire que 120; correction+5→125, moins prioritaire.
La page 16 associe une correction négative à la récompense des tâches E/S, mais la page 17 dit que la valeur dynamique « augmente » avec le temps bloqué. Avec la formule additive et le sens des numéros, une augmentation numérique produirait l’effet inverse. L’interprétation cohérente est bonus ou priorité effective accrus, donc correction numérique plus négative. La phrase ambiguë ne doit pas être appliquée comme une autre règle arithmétique. Cette adaptation concerne NORMAL; elle n’est pas appliquée de la même manière aux politiques temps réel FIFO/RR.
5.5. Quantum et exemple de deux tâches sur deux epochs
Pour le niveau SP utilisé dans le tableau du support, la tranche est :
Source TeX à sélectionner et copier
T_{slice}(SP)=
\begin{cases}
(140-SP)\times20\ \mathrm{ms},&SP<120,\\
(140-SP)\times5\ \mathrm{ms},&SP\ge120.
\end{cases}| SP | Nice associé | Tranche |
|---|---|---|
| 100 | −20 | 800 ms |
| 110 | −10 | 600 ms |
| 120 | 0 | 100 ms |
| 130 | +10 | 50 ms |
| 139 | +19 | 5 ms |
La fonction est par morceaux, avec un changement à 120; remplacer les deux coefficients par une progression unique est faux. Ces tranches sont celles du modèle historique, pas des valeurs universelles de Linux.
Le parcours NORMAL part du niveau 100 de l’active. Chaque tâche du niveau reçoit sa tranche; si elle reste inachevée après expiration, elle passe à l’expirée. Quand le niveau actif est vide, avancer au suivant. À 140, l’active est épuisée : échanger les pointeurs et repartir à 100.
L’exemple prend P3=140 ms et P4=43 ms, tous deux au niveau 120, donc q=100 ms. P3 consomme 100 et conserve 40 pour un prochain epoch; P4 consomme 43 et termine. Le premier passage vaut 143 ms, pas 183 : les 40 de P3 sont dans l’expirée. Si ce sont les seules tâches, le passage suivant termine P3 après 40 et le total est 183 ms. Les ellipses du schéma peuvent représenter d’autres tâches actives à servir avant l’échange; aucune durée n’est donnée pour elles.
5.6. Yield : céder n’est pas synchroniser
Le schéma O(1) représente sched_yield() par le transfert de l’appelant de l’active à l’expirée, laissant avancer les autres tâches actives. Cela explique son intention de cession.
L’idée « tous les autres threads seront réexécutés » reste une simplification de ce modèle. Yield n’est ni une barrière ni une garantie que chaque autre thread a franchi une étape. Un appelant seul au niveau admissible peut continuer; le comportement sous la politique ordinaire ne fournit pas un ordre déterministe de programme. Les exercices du labo qui doivent toujours afficher une permutation utilisent donc des sémaphores, pas une supposition sur yield. Documentation Linux sched_yield.
5.7. CFS : équité par poids, tâches et groupes
Le modèle CFS imagine un CPU idéal qui distribue simultanément sa puissance aux N tâches prêtes. Pour des poids égaux, chaque tâche reçoit 1/N. Avec des poids différents, l’équité signifie respecter les proportions, pas donner un nombre identique de millisecondes.
Le support compare A avec 48 tâches et B avec 2, toutes de même niveau. Un partage par tâche donne A=48/50=96 % et B=2/50=4 %. Le résultat 50/50 par utilisateur suppose un partage par groupes configurés. Cette extension n’est pas une garantie automatique de toute configuration CFS; il faut savoir quelle unité reçoit l’équité. Extension de groupes CFS.
Chaque niveau p=120+nice a un poids w. Plus w est grand, plus sa fraction de CPU est grande. Approximativement :
Source TeX à sélectionner et copier
\frac{w(p-1)}{w(p)}\approx1{,}25.Diminuer nice d’un point augmente donc le poids d’environ 25 %. Pour les résultats exacts, prendre la table précalculée de 40 entrées; nice lui-même n’est pas le poids :
Code (text) · sélectionner pour copier
nice -20..-16 : 88761 71755 56483 46273 36291
nice -15..-11 : 29154 23254 18705 14949 11916
nice -10.. -6 :  9548  7620  6100  4904  3906
nice  -5.. -1 :  3121  2501  1991  1586  1277
nice   0..  4 :  1024   820   655   526   423
nice   5..  9 :   335   272   215   172   137
nice  10.. 14 :   110    87    70    56    45
nice  15.. 19 :    36    29    23    18    15
5.8. Calcul pondéré sur une période
T_period est la période idéale où chacun des N participants prêts passerait une fois. Pour le poids w_i :
Source TeX à sélectionner et copier
f_i=\frac{w_i}{\sum_{j=1}^{N}w_j},\qquad
T_{slice,i}=T_{period}f_i.
Le dénominateur inclut tous les participants prêts du calcul. Les fractions doivent totaliser 1 et les tranches T_period. Une valeur nice, éventuellement négative, ne peut pas remplacer w dans cette fraction.
Premier exemple : T_period=15 ms, poids 1024,526,272, somme 1822 :
| Tâche | Nice | p | w | Fraction | Tranche |
|---|---|---|---|---|---|
| PA | 0 | 120 | 1024 | 56,202 % | 15×1024/1822=8,4303 ms |
| PB | 3 | 123 | 526 | 28,869 % | 15×526/1822=4,3304 ms |
| PC | 6 | 126 | 272 | 14,929 % | 15×272/1822=2,2393 ms |
La tranche PB à deux décimales est 4,33 ms, malgré 4,34 dans la diapositive. Avec 8,43 et 2,24, les arrondis corrigés totalisent 15,00 ms; les valeurs non arrondies totalisent exactement 15.
Deuxième exemple : PA au niveau 120/poids 1024 et PB au niveau 125/poids 335. Somme 1359, même période 15 ms :
Source TeX à sélectionner et copier
T_A=15\frac{1024}{1359}=11{,}3024\ \mathrm{ms},\qquad
T_B=15\frac{335}{1359}=3{,}6976\ \mathrm{ms}.
15 ms vaut 15000000 ns. Les barres du support illustrent un partage idéal répété; elles ne prouvent pas une séquence réelle fixe indépendante des arrivées, interruptions ou de la granularité du noyau. Le PDF développe ce calcul pondéré, sans donner l’implémentation interne complète de CFS.